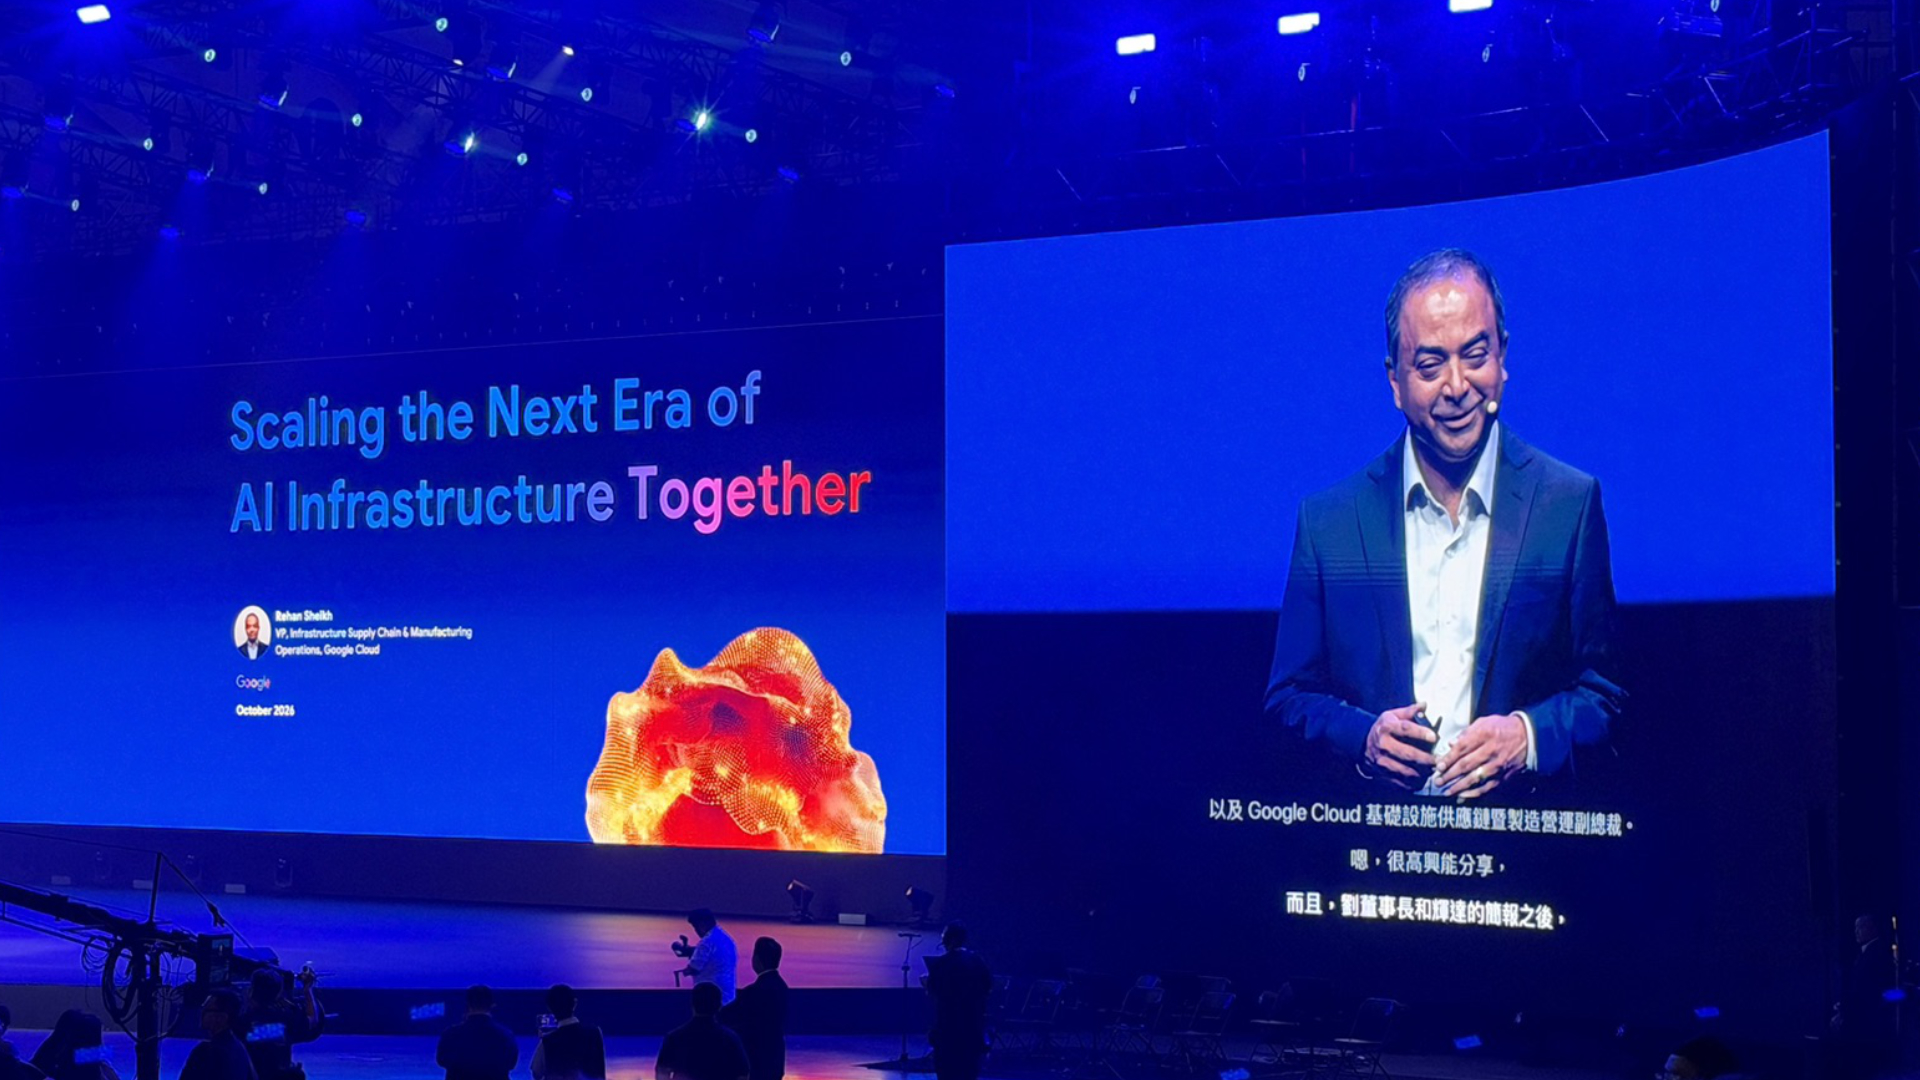
Google Cloud 基礎設施供應鏈暨製造營運副總裁 Mehdi Sheikh 於 2026 年鴻海科技日發表演講,分享 Google 在 AI 基礎設施、客製化晶片與全球供應鏈的發展方向,他表示生成式 AI 與前沿模型的快速發展,不只是軟體技術的革新,也帶動實體運算基礎設施與製造模式轉變。面對持續增加的 AI 運算需求,Google 希望與鴻海及其他供應鏈夥伴深化合作,從傳統硬體供應關係朝向長期策略夥伴關係發展,同時加快 AI 晶片與資料中心系統的部署速度。
Google 深化與鴻海合作,台灣供應鏈支撐 AI 基礎設施發展
Mehdi Sheikh 負責 Google 全球硬體需求所涉及的供應鏈採購、製造營運、新產品導入及設備交付,涵蓋運算、儲存、網路與機器學習等基礎設施,Google 必須將不同服務產生的運算需求轉換為實際硬體設備,並透過鴻海等合作夥伴完成製造與部署,雙方過去已在 Alphabet 旗下多項硬體業務建立合作基礎,包括與機器人技術公司 Intrinsic 相關的合作,如今也將既有製造與供應鏈經驗延伸至全球 AI 資料中心;Mehdi Sheikh 特別提及鴻海董事長劉揚偉所強調的垂直整合能力,認為鴻海橫跨多項硬體領域的製造布局,是雙方合作的重要基礎。另一方面,台灣聚集半導體製造、先進封裝與工程技術人才,也讓 Google 能夠更有效率地推動客製化晶片與 AI 系統開發。
Google 從 TPU 、 NVIDIA GPU 到 Gemini 建立完整 AI 架構
對於外界關注 AI 需求是否能夠持續成長,Mehdi Sheikh 從 Google 的技術架構與實際應用說明硬體需求來源;他指出,Google 從底層客製化 Tensor Processing Unit(TPU)、與 NVIDIA 合作的 GPU 、光路交換器、液冷技術到大型資料中心,逐步建立完整的 AI 運算基礎設施,上層結合 Gemini 模型、 BigQuery 、 Spanner 及 AlloyDB 等資料管理服務,並透過 Mandiant 等安全技術支援雲端環境;這套架構最終服務於 Gemini 、 Google Search 、 YouTube 及 Google Workspace 等產品,讓 Google 能從晶片、系統到應用進行共同設計與效能最佳化。由於旗下服務擁有龐大使用者規模,Google 也能依據實際產品使用情況與客戶需求規劃硬體資源。
Mehdi Sheikh 強調,AI 基礎設施需求不只是市場預期,也有既有客戶訂單與待交付業務作為支撐。
TPU 自 2015 年開始部署,Google 加快訓練與推論晶片開發
談到客製化 AI 晶片的發展,Mehdi Sheikh 回顧 Google 自 2015 年部署第一代 TPU 以來的技術演進,Google 早期便意識到,針對特定運算工作負載開發專用加速器,對提升大規模服務效率具有重要性;隨著 AI 模型規模擴大與應用需求增加,TPU 的開發節奏也持續加快,並逐步針對模型訓練與推論發展不同的晶片設計。這不僅涉及晶片本身的運算能力,也包括記憶體配置、系統整合及大型運算叢集的建置。
Mehdi Sheikh 指出,晶片完成開發後,還必須經過驗證、硬體系統建置與資料中心部署,才能真正投入服務,因此 Google 與供應鏈夥伴需要同步加快晶片開發及後續硬體交付的速度。
AI 晶片部署不能再等 12 至 18 個月,Google 推動供應鏈流程調整
Mehdi Sheikh 進一步表示,傳統從晶片可用、系統驗證到資料中心正式部署的流程,可能需要 12 至 18 個月,但在 AI 技術快速迭代的環境下,既有開發與製造模式已難以滿足需求;為縮短晶片投入實際服務所需時間,Google 正與合作夥伴調整作業方式,包括提前規劃上游物料與產能、讓部分系統驗證及製造準備工作平行進行,並加強完整硬體系統的測試與生產協調。
此外,Google 也將供應鏈合作、全球產能布局、自動化與即時數據分析視為重要方向,希望透過更早期的共同設計、跨區域製造資源配置及即時產能資訊,提高硬體交付效率。