微軟宣布擴大 Azure Maia 系列 AI 加速器部署,計畫於 2027 年將整體規模提升至數 GW(Gigawatt,十億瓦)等級,逐步成為旗下產品與服務的主要 AI 推論基礎建設,其中現有 Maia 200 已投入 Microsoft Copilot 等實際工作負載,新一代 Maia 300 則採用台積電 N2P 製程與 HBM4 高頻寬記憶體,針對長上下文推理、對話式 AI 及多步驟 AI 代理任務進行最佳化。
微軟預期,Maia 300 每兆瓦 token 處理量相較頂尖 GPU 運算系統提升 40%,完整 96 顆加速器配置的機櫃級處理量,最高可達 Maia 200 的 7 倍,預計 2027 年開始正式生產部署。
Maia 200 已投入 Microsoft Copilot 服務,推論效率達頂尖 GPU 架構 1.7 倍
Azure Maia 是微軟自行開發的 AI 加速器系列,設計方向以旗下大規模 AI 服務的實際需求為基礎,並透過軟硬體協同設計,整合晶片架構、記憶體配置、網路互連與應用程式最佳化;由於 AI 晶片研發週期長達數年,微軟從開發初期便由硬體與軟體團隊共同規劃,提前因應未來模型對運算能力、記憶體容量與頻寬的需求。
目前 Maia 200 已部署於美國、歐洲及澳洲,支援 Microsoft Teams、Microsoft Copilot 與 Cowork 等服務中的 AI 功能,同時協助 Microsoft AI(MAI)團隊開發新一代模型。微軟指出,Maia 200 相較業界頂尖 GPU 基礎架構,每瓦 token 處理量最高可達 1.7 倍。
在模型支援方面,Maia 200 可執行 OpenAI 模型、微軟自行研發的 MAI 模型,以及主流開源模型系列。GitHub Copilot 與 Microsoft Foundry 也預計於 2026 年底加入 Maia 200 支援範圍,進一步擴大至程式開發、模型部署及企業 AI 應用。
微軟表示,Azure Maia 系統的設計也涵蓋 GitHub Copilot 所需的多步驟 AI 代理工作、Microsoft Foundry 支援不同模型架構的雲端服務,以及 MAI 團隊的模型推論與資料生成需求;此外,Dragon Copilot 所需的低延遲互動與臨床工作流程,也是系統最佳化考量的應用場景之一。
Maia 300 採推論優先架構,每兆瓦處理量預期提升 40%
作為 Azure Maia 計畫的第三代產品,Maia 300 採用推論優先(inference-first)架構,主要因應大型 AI 模型長上下文、高記憶體需求,以及大量輸出 token 的解碼密集型(decode-heavy)工作負載,同時支援需要長時間持續執行的多步驟 AI 代理任務。
微軟預期,相較頂尖 GPU 運算系統,Maia 300 每兆瓦的 token 處理量可提升 40%;在整合 96 顆加速器的完整機櫃配置下,token 處理量最高可達 Maia 200 的 7 倍。相關數據屬於微軟對新一代系統的預期效能,Maia 300 預計於 2027 年正式開始生產部署。
Maia 300 的另一項設計重點是降低 AI 推論過程中的資料移動成本;微軟指出,隨著模型規模擴大,資料在運算單元、記憶體及網路之間移動的效率,已逐漸成為影響整體效能的重要因素。
因此,Maia 300 導入軟體定義資料流程架構,搭配 AI 輔助的核心(kernel)最佳化,改善資料區域性並減少不必要的資料傳輸,以提升運算、記憶體及網路資源的使用效率;這項架構也讓微軟能針對不同模型及企業應用調整資料處理方式,在雲端規模下平衡運算效能、能源消耗與系統部署成本。
台積電 N2P 製程結合 HBM4,記憶體頻寬最高 18TB/s
硬體設計方面,Maia 300 採用全新多顆小晶片(chiplet)架構,將運算、記憶體控制器及 I/O 功能分別配置,並採用台積電 N2P 製程節點,藉此改善能源效率、系統擴充能力及成本結構。
記憶體部分,Maia 300 搭載 8 組 HBM4 高頻寬記憶體堆疊,在 950W 熱設計功耗(TDP)條件下,最高可提供 18.0TB/s 記憶體頻寬,主要用於支援大型 AI 模型與長上下文工作負載。系統另外透過專用核心,將晶粒內 SRAM 作為由軟體管理的暫存空間(scratchpad),降低運算過程對 HBM 的存取需求。
為減少模型運算與資料儲存所需資源,Maia 300 也針對強化版 MXFP4 等低精度數值格式進行設計,可降低運算與 KV 快取(KV-Cache)使用的記憶體容量及頻寬需求,讓系統在相同功耗範圍內支援更長的上下文視窗與更高的 token 處理量。
這些調整延續微軟在 Maia 200 上累積的實際運行經驗,將軟體資料流程與硬體記憶體架構整合,因應不同 AI 模型對記憶體、頻寬及運算效率的需求。
單機櫃整合 96 顆加速器,2027 年展開正式部署
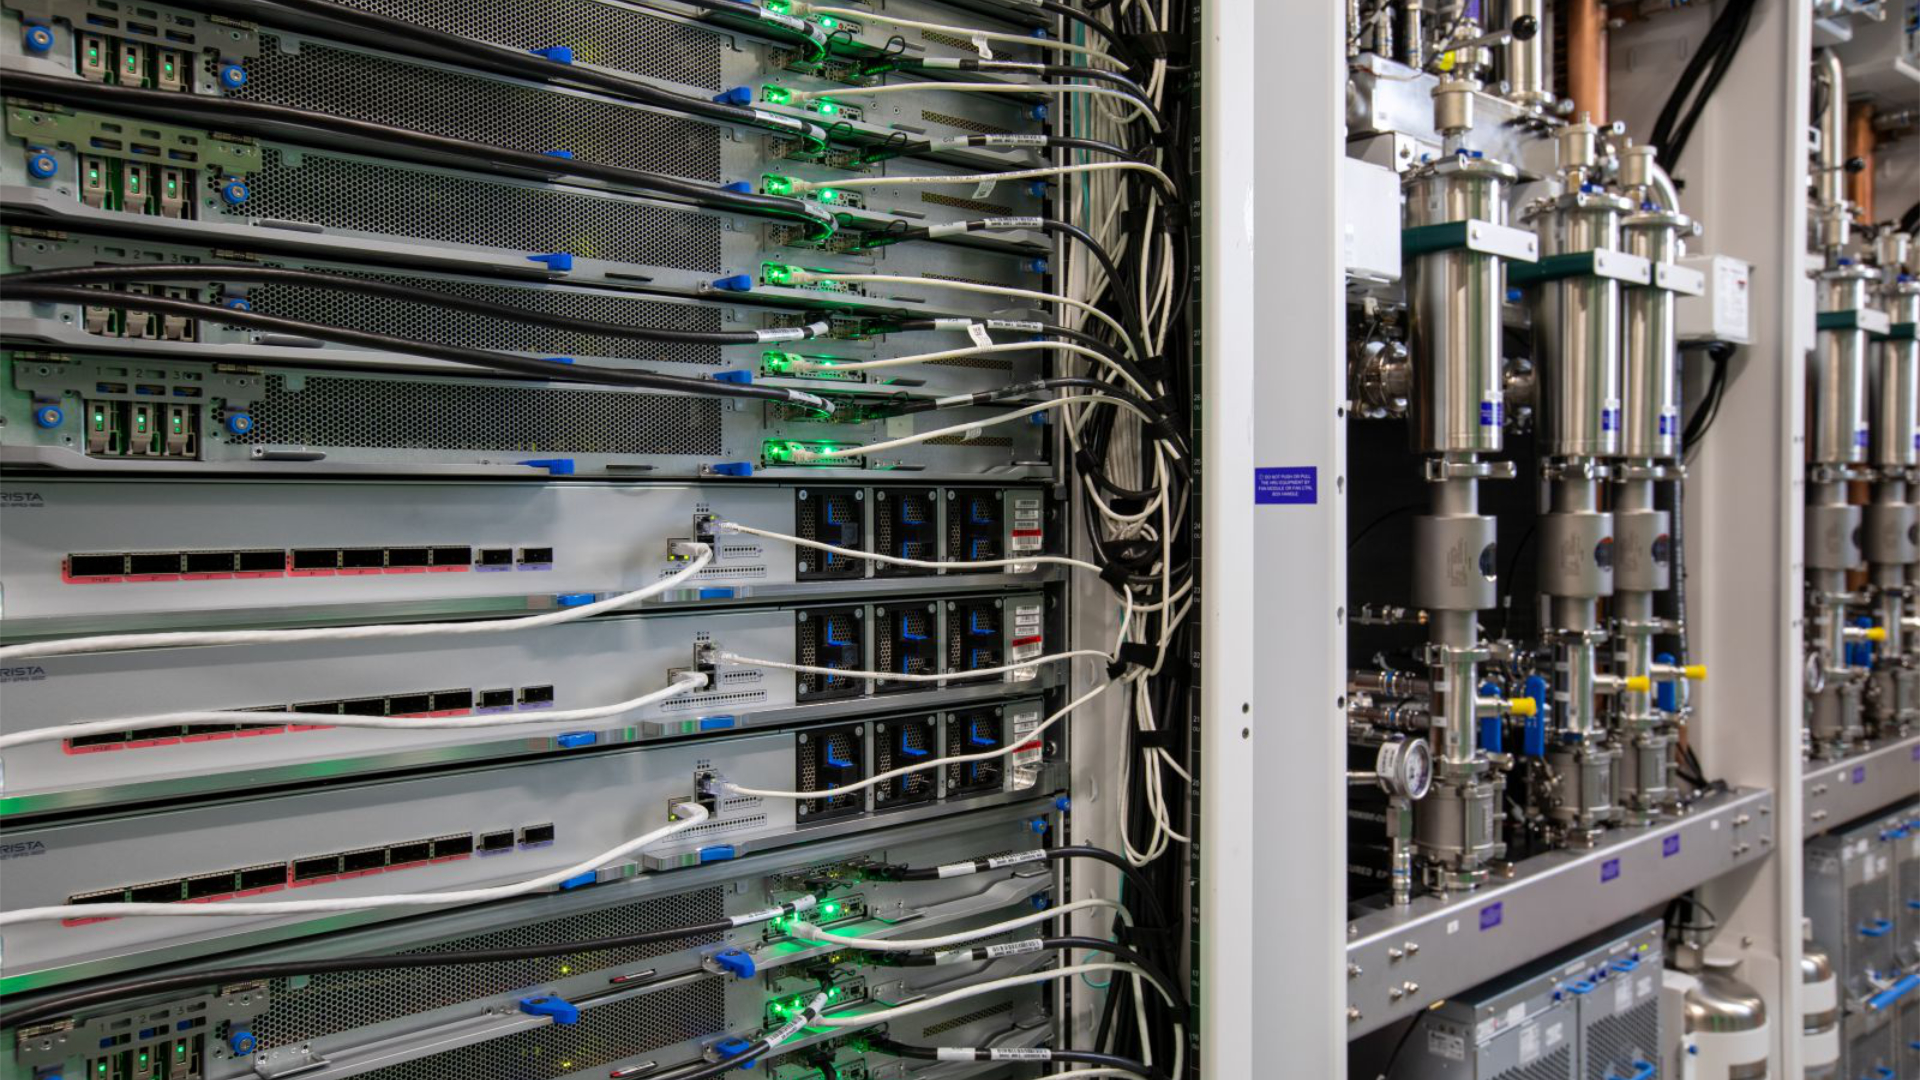
在機櫃級系統方面,Maia 300 可於 167kW 功耗範圍內整合 96 顆 AI 加速器,提供總計 27.6TB 的 HBM 記憶體容量,以及 1.7PB/s 的 HBM 總頻寬。透過高密度加速器配置,系統可同時處理更多 AI 互動請求,並支援規模更大的模型工作負載。
為了讓加速器之間維持高效率資料交換,Maia 300 將網路互連整合至軟體定義資料流程架構,透過高頻寬互連技術支援張量平行化(tensor parallelism),並利用客製化 AI 資料傳輸機制,改善不同加速器與機櫃之間的通訊效率。
網路架構則採用經 AI 最佳化、以乙太網路(Ethernet)為基礎的傳輸技術,建立統一網路拓撲,使 Maia 300 能從單一機櫃擴展至資料中心規模,同時維持運算、記憶體與網路資源之間的協同運作。
依照微軟規劃,Maia 300 將於 2027 年正式開始生產部署,Azure Maia 系列也將持續擴大至數 GW 規模,成為 Microsoft Copilot、GitHub Copilot、Microsoft Foundry 及其他 AI 服務的重要推論基礎建設。
微軟強調,未來 AI 平台將持續支援不同模型與異質運算架構,並從晶片、系統到 AI 代理應用進行整合;公司也預計於 2026 年 11 月在美國舊金山及線上舉辦 Microsoft Ignite 2026,進一步分享 AI 基礎建設策略、技術採用趨勢與企業應用案例。